À retenir : – ollama adopte le framework mlx d’apple pour l’ia – meilleure exploitation de l’architecture des puces apple silicon – gain de vitesse et fluidité dans les réponses générées – expérience optimisée réservée aux macs haut de gamme – promesse d’une plateforme de référence pour l’ia personnelle
Ollama a récemment intégré le framework MLX d’Apple pour améliorer le fonctionnement de ses modèles d’intelligence artificielle sur les Mac équipés des puces Apple Silicon. Cet outil, qui est déjà très populaire pour faire tourner des modèles de langage en local sur macOS, Linux et Windows, voit ainsi ses performances nettement rehaussées. L’écosystème Mac s’affirme donc comme une option crédible pour l’IA embarquée.
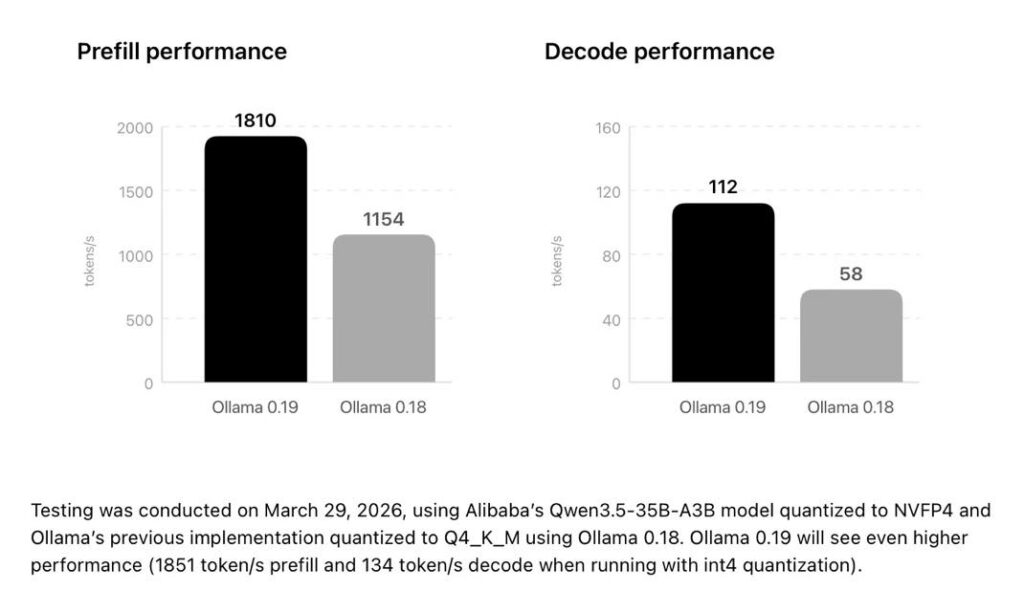
Auparavant, Ollama permettait de charger et d’exécuter des modèles open source localement, mais l’expérience était souvent limitée par la mémoire disponible et par les capacités de traitement des machines grand public. Avec l’adoption de MLX sur les Mac Apple Silicon, l’application peut mieux tirer parti de l’architecture à mémoire unifiée des puces conçues par Apple. Ce changement se traduit par une augmentation significative de la vitesse sur tous les Mac compatibles avec ces puces : cela signifie que le temps nécessaire avant le premier token diminue et que le débit de génération s’améliore. En d’autres termes, les réponses sont fournies plus rapidement et s’enchaînent de manière plus fluide, transformant ainsi l’expérience utilisateur avec les modèles locaux.
Cette avancée est particulièrement pertinente pour ceux qui utilisent des assistants personnels ou développent des applications directement sur leur machine. En effet, il ne s’agit pas seulement d’un confort accru ; cela touche aussi aux questions de confidentialité, à l’autonomie hors ligne et à un meilleur contrôle sur les données traitées.
Cependant, cette évolution présente également une contrainte majeure : Ollama recommande un Mac disposant d’au moins 32 Go de mémoire unifiée pour bénéficier pleinement des avantages offerts par cette nouvelle technologie. Ainsi, seuls les utilisateurs disposant d’équipements relativement haut de gamme pourront accéder à cette expérience optimisée.
L’intégration du MLX dans Ollama démontre qu’Apple ne se limite pas uniquement au développement interne d’IA via ses propres fonctionnalités système. La société californienne construit également discrètement un cadre technique visant à attirer davantage développeurs et outils tiers vers le calcul local sur ses machines. À mesure que l’efficacité des modèles augmente et que leur utilisation évolue loin du tout-cloud vers davantage de solutions locales, il est envisageable que le Mac devienne une plateforme privilégiée pour l’IA personnelle et embarquée


Super article ! Je suis trop content de voir que l’IA sur Mac progresse. J’ai hâte d’essayer Ollama avec MLX
Je rigole en lisant certains commentaires… Comme si un peu de rapidité allait régler tous les problèmes du monde. 😂
Arrêtez de vous emballer pour un outil parmi tant d’autres. Vous croyez vraiment que ça va changer la face du monde ?
Ah voilà encore une promesse en l’air… Des progrès OK, mais toujours pas accessible au commun des mortels ! 🙄
L’optimisation est top mais bon, faut pas se voiler la face : tout le monde peut pas se payer un Mac à 2000 balles
Ollama qui se modernise, c’est le rêve des utilisateurs de Mac! Enfin une amélioration qui compte vraiment
Si vous avez pas encore testé Ollama avec MLX, foncez ! C’est fluide et rapide comme jamais auparavant!
C’est marrant comment y’a toujours les raleurs qui viennent casser l’ambiance. Profitez un peu des avancées technologiques !
Franchement, je comprends pas pourquoi tout le monde s’excite pour ça. Un Mac c’est bien, mais faut avoir les moyens !
Dites ce que vous voulez, mais ces nouvelles fonctionnalités font du bien au milieu Apple. Vivement plus d’améliorations!
Trop bien cette évolution ! Franchement, j’aurais jamais cru qu’on pourrait faire tourner des modèles IA aussi facilement sur Mac