À retenir : – Optimisation de la synthèse vocale avec une nouvelle méthode. – Accélération de 40 % sans sacrifier qualité ni compréhension. – Méthode Principled Coarse-Graining (PCG) introduite pour améliorer le processus. – Taux d’erreur sur les mots inférieur aux techniques précédentes. – Facilité d’intégration dans les systèmes existants sans nouvel entraînement.
Apple fait un bond en avant dans la synthèse vocale grâce à l’intelligence artificielle. Des chercheurs de la firme et de l’université de Tel-Aviv ont révolutionné le domaine en optimisant la génération vocale. Leur approche, détaillée dans une étude récente, permet d’accélérer de 40 % le processus de conversion du texte en parole par IA tout en conservant une excellente qualité audio et une bonne compréhension.
L’étude se penche sur les modèles autorégressifs, qui sont similaires aux grands modèles de langage mais adaptés au son. Ces systèmes fonctionnent généralement en prédisant chaque fragment audio successif basé sur ceux déjà générés, ce qui peut créer des ralentissements dans le processus. En effet, les chercheurs soulignent que la correspondance stricte des segments audio peut limiter les prédictions auditivement correctes simplement parce qu’elles ne correspondent pas exactement au token attendu par l’algorithme.
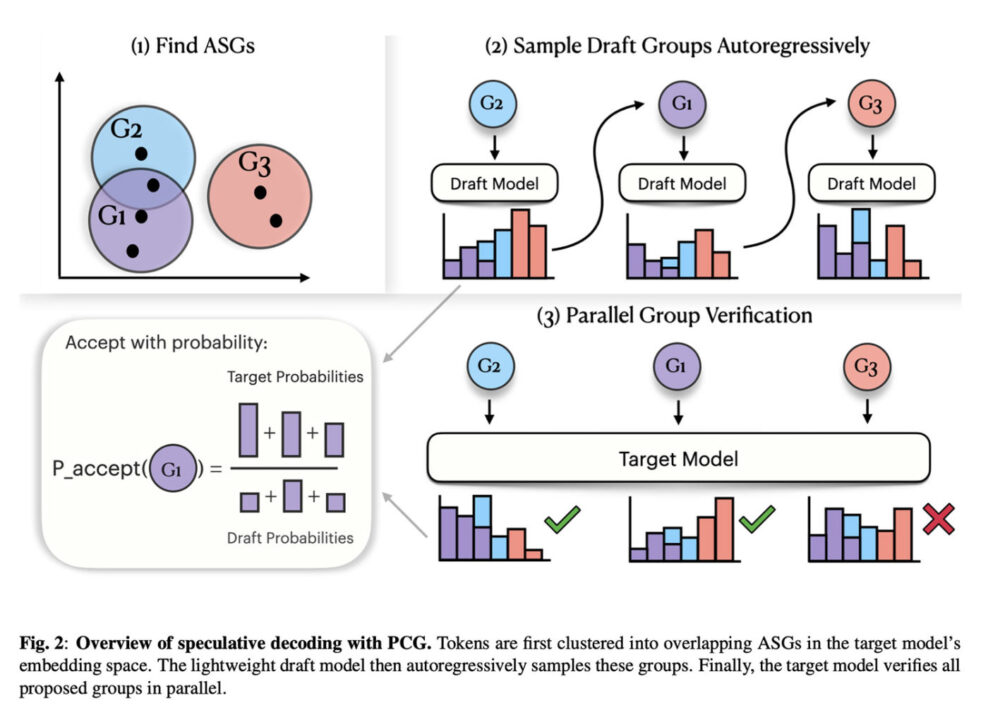
Pour surmonter ce problème, l’équipe a mis au point une méthode innovante appelée Principled Coarse-Graining (PCG). Ce concept repose sur l’idée que plusieurs fragments sonores peuvent produire des effets similaires pour l’auditeur. Ainsi, plutôt que d’analyser chaque son comme une entité unique et rigide, cette technique regroupe les tokens similaires.
En pratique, PCG utilise deux modèles : un modèle plus petit et rapide qui suggère des fragments audio et un second modèle plus volumineux qui vérifie si ces suggestions appartiennent à un groupe acoustique adéquat avant validation. Cette approche flexible s’inspire du décodage spéculatif appliqué aux voix.
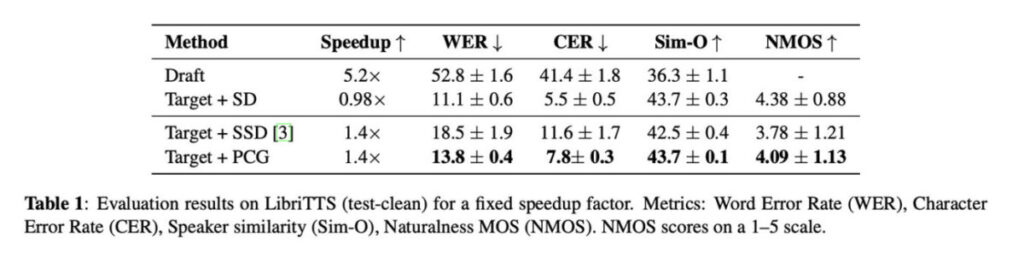
Les résultats obtenus sont impressionnants : la génération vocale est accélérée d’environ 40 %, marquant ainsi une avancée significative comparée à ce que proposait le décodage spéculatif traditionnel, qui offrait peu ou pas d’amélioration speedique.
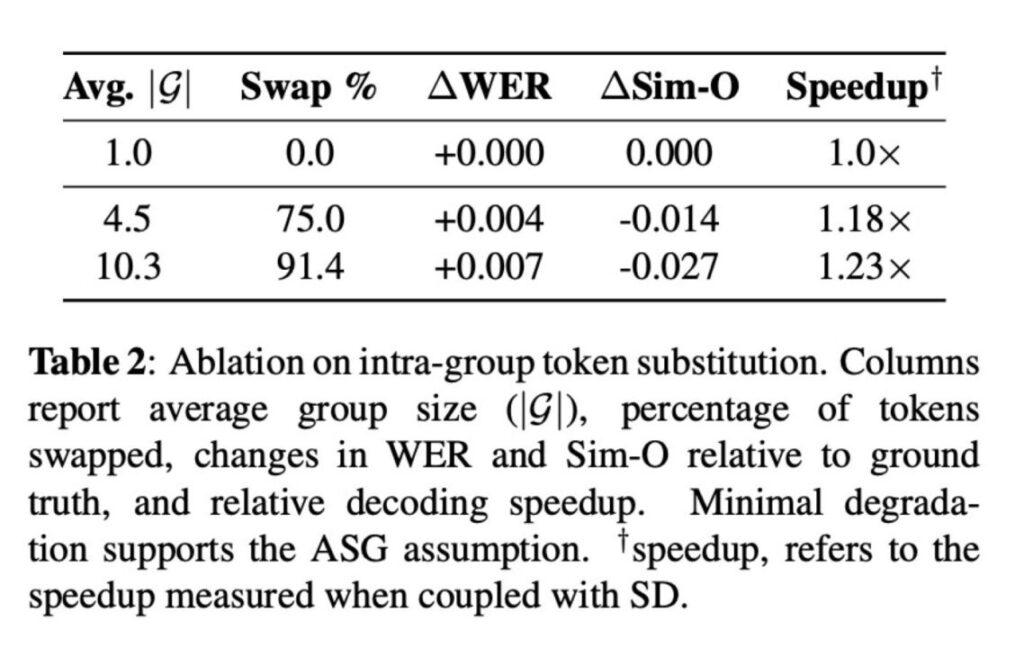
La méthode PCG a également réussi à maintenir un taux d’erreur sur les mots moins élevé que les techniques précédentes tout en préservant les caractéristiques vocales du locuteur concerné. Sur une échelle allant de 1 à 5 pour évaluer le naturel de la synthèse vocale, elle obtient un score très satisfaisant de 4,09. Lors d’un test très rigoureux où 91,4 % des tokens ont été remplacés par des alternatives acoustiquement similaires, la qualité sonore est restée claire avec seulement une légère augmentation du taux d’erreur (+0,007) et un déclin négligeable dans la similarité (-0,027).
Un atout majeur de cette technologie réside également dans sa facilité d’intégration : elle nécessite simplement des modifications lors du décodage sans nécessiter un nouvel entraînement des modèles ou ajustements architecturaux. Cela permet son application immédiate dans divers systèmes pendant la phase d’inférence sans lourdes exigences matérielles additionnelles — seulement 37 Mo supplémentaires pour stocker ces groupes acoustiquer rend cette solution particulièrement adaptée aux appareils dotés d’une mémoire limitée.
Reste maintenant à observer comment Apple prévoit de déployer ces avancées sur ses iPhones et autres produits dans le futur ; aucune information n’a encore été communiquée à ce sujet pour le moment